En nuestra guía de RAG explicamos cómo hacer que un LLM responda con los datos de tu empresa: trocear documentos, generar embeddings, buscar por similitud y pasarle al modelo solo lo relevante. El tutorial funciona, la demo impresiona, y entonces llega la pregunta que de verdad importa: ¿lo llevamos a producción?
Y aquí viene la parte incómoda: en una parte importante de los proyectos que revisamos, RAG no era la respuesta correcta. No porque la técnica falle — funciona muy bien cuando toca — sino porque el problema se resolvía con algo mucho más simple. Esta guía es la conversación honesta que tenemos con cada cliente antes de encender la primera base de datos vectorial.
El Problema: La Demo Miente
Una demo de RAG es engañosamente fácil: cincuenta PDFs, un índice vectorial, una pregunta bien elegida y una respuesta que parece magia. Producción es otra película:
- Los documentos no son cincuenta PDFs limpios: son diez mil ficheros con versiones contradictorias, tablas rotas y permisos por departamento.
- Las preguntas no son la del demo: son ambiguas, con jerga interna, y a veces no tienen respuesta en la documentación — y el modelo la inventará si no se lo impides.
- La respuesta ya no es para impresionar a dirección: la usa un empleado para decidir, o peor, un cliente.
La distancia entre «funciona en mi portátil» y «responde en producción todos los días» es donde vive el 90% del trabajo — y donde hay que decidir si el camino pasa por RAG o por otro sitio.
Primero lo Primero: ¿Necesitas RAG en Absoluto?
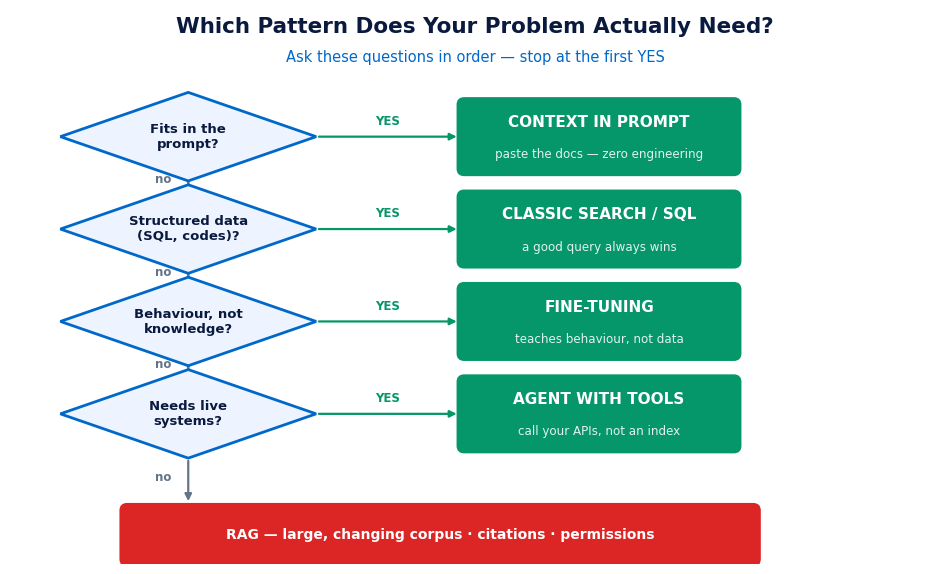
Antes de arquitectura, la pregunta eliminatoria. Hay cuatro alternativas que resuelven problemas que parecen de RAG y no lo son:
- Meter el contexto directamente en el prompt. Si tu documentación relevante cabe en la ventana de contexto del modelo (y hoy las ventanas son enormes), no necesitas recuperación: pégala entera o por secciones. Coste de ingeniería: casi cero.
- Búsqueda clásica (full-text, filtros, SQL). Si el usuario busca cosas concretas — una factura, un pedido, un artículo por su código — una query bien hecha gana siempre a un embedding. Los LLMs no sustituyen a los índices que ya tienes.
- Fine-tuning. Si el problema es de comportamiento (tono, formato, estilo de respuesta) y no de conocimiento, el fine-tuning es la herramienta. RAG enseña datos; el fine-tuning enseña maneras. Confundirlos es el error más caro de esta lista.
- Un agente con herramientas. Si la respuesta exige consultar sistemas vivos (el ERP, la API de stock, el CRM), no quieres un índice estático de documentos: quieres que el modelo llame a tus APIs. Eso es otro patrón.
RAG entra cuando ninguna de las cuatro encaja: el conocimiento es grande, cambia con frecuencia, y no cabe en el prompt. Documentación técnica extensa, bases de conocimiento de soporte, normativa que se actualiza, repositorios de contratos. Ahí RAG no es una opción más: es la opción.
Señales de que RAG SÍ Merece la Pena
- Corpus grande y cambiante. Miles de documentos que se actualizan semanalmente; reindexar es viable, re-entrenar no.
- La trazabilidad es requisito. Necesitas citar la fuente de cada respuesta («según el contrato X, cláusula 4.2»). RAG la da de forma natural; el fine-tuning, no.
- Permisos por usuario. Cada usuario solo puede recibir respuestas basadas en documentos a los que tiene acceso. Filtrar en la recuperación es factible; «desaprender» de un modelo fine-tuneado, imposible.
- Las alucinaciones tienen coste real. Soporte al cliente, legal, sanidad, finanzas: anclar las respuestas a documentos recuperados es la mitigación más efectiva que existe.
- El conocimiento no es público. Está en tu wiki, tus PDFs, tus sistemas — el modelo nunca lo ha visto en entrenamiento y ninguna cantidad de prompt engineering lo inventará correctamente.
Señales de que es Sobreingeniería
- Tu corpus cabe en el prompt. Si son veinte documentos que cambian poco, un buen system prompt con el contenido te da el mismo resultado por el 5% del coste.
- El problema es de formato, no de conocimiento. «Quiero que responda como nuestro tono de marca» no se arregla con vectores.
- Los datos ya tienen estructura. Si la respuesta está en una base de datos relacional, escribe la query (o deja que el modelo la escriba): no conviertas filas perfectas en trozos de texto difuso.
- No tienes quién lo mantenga. Un RAG en producción es un sistema vivo: pipelines de ingestión, reindexados, evaluación de calidad. Sin dueño, se degrada en silencio hasta que alguien nota que responde con la versión de 2024 del manual.
Lo que Cambia en Producción (y Nadie Pone en los Tutoriales)
Si has decidido que RAG es tu patrón, esto es lo que separa el tutorial del sistema real:
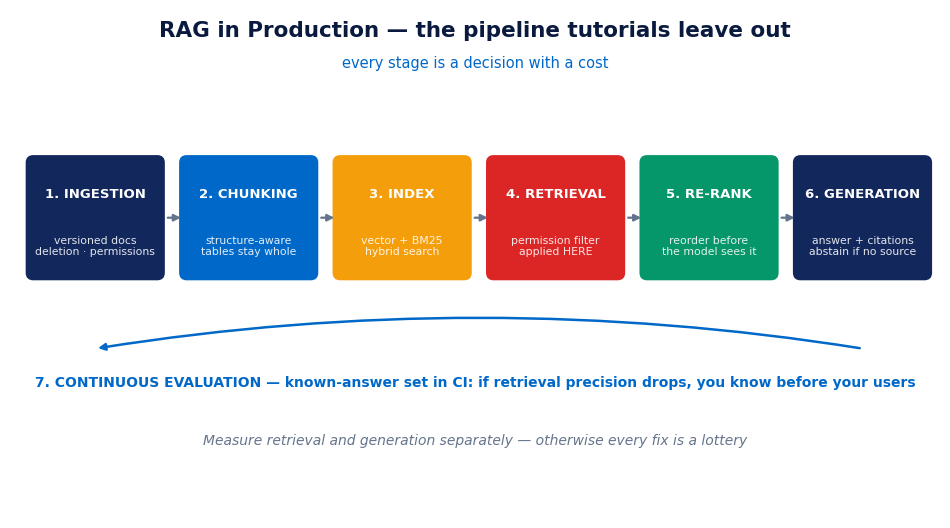
- Ingestión con versionado y borrado. Los documentos se actualizan y a veces deben desaparecer (RGPD, contratos rescindidos). Necesitas saber qué trozos vienen de qué documento y poder reemplazarlos o eliminarlos — «reindexar todo desde cero cada noche» deja de ser gracioso con diez mil documentos.
- El chunking es una decisión de producto. Trocear por tamaño fijo rompe tablas y corta definiciones a la mitad. Trocear respetando la estructura (títulos, secciones, tablas enteras) es la diferencia entre respuestas mediocres y buenas, y exige un parser por tipo de documento.
- Permisos en la recuperación, no en la respuesta. El filtro de acceso se aplica al buscar (cada usuario recupera solo lo suyo), nunca como instrucción al modelo de «no menciones esto». Lo segundo no es seguridad: es una sugerencia.
- Recuperación híbrida y re-ranking. La búsqueda vectorial sola falla con códigos, siglas y números de parte. Combinarla con búsqueda por palabra clave (BM25) y re-ordenar los resultados antes de pasarlos al modelo mejora la precisión más que cualquier cambio de prompt.
- Evaluación continua. Un conjunto de preguntas con respuesta conocida que corre en CI y en horario: si la precisión de recuperación baja del umbral, te enteras antes que tus usuarios. Sin esto, el sistema se degrada en silencio.
- Latencia y coste por respuesta. Cada respuesta paga: búsqueda + re-ranking + generación con contexto largo. Medirlo por consulta — y cachear las preguntas frecuentes — es lo que decide si el proyecto es sostenible o una demo cara.
Errores Comunes
- Empezar por la base de datos vectorial. La elección entre pgvector, Qdrant o Pinecone es la decisión menos importante del proyecto; la calidad de la ingestión y del chunking es la más importante.
- No medir la recuperación por separado. Si una respuesta es mala, ¿falló la búsqueda o la generación? Sin métricas separadas, cada arreglo es una lotería.
- Confiar la seguridad al prompt. «No reveles información confidencial» escrito en el system prompt no es un control de acceso.
- Indexar basura. Si el 40% del corpus está desactualizado o duplicado, el 40% de las respuestas se apoyará en basura. La curación del corpus es trabajo de negocio, no de ingeniería.
- Prometer precisión sin evaluación. «Funciona bastante bien» no es una métrica. Un set de evaluación de 50 preguntas reales, construido antes del lanzamiento, vale más que cualquier benchmark ajeno.
En Resumen
RAG es el patrón correcto cuando el conocimiento es grande, cambia con frecuencia, requiere citas y permisos, y no cabe en el prompt. Es sobreingeniería cuando una query, un buen prompt o un agente con herramientas resuelven el mismo problema. Y cuando toca, producción exige lo que los tutoriales callan: ingestión versionada, chunking que respeta la estructura, permisos en la recuperación, búsqueda híbrida y evaluación continua. La demo es el 10%; el resto es ingeniería seria.
Si estás valorando llevar IA con datos propios a producción — o ya lo hiciste y las respuestas no están a la altura — es exactamente el tipo de sistemas que diseñamos y auditamos. Hablemos de tu caso →
Sigue leyendo: RAG: Cómo hacer que un LLM responda con los datos de tu empresa.