Pregúntale a ChatGPT por tu catálogo de productos, tus políticas internas o el histórico de un cliente concreto. Responderá con total seguridad, buena prosa… y datos inventados. Los LLMs saben mucho de todo y nada de tu empresa: su conocimiento se congeló el día de su entrenamiento.
RAG (Retrieval-Augmented Generation, generación aumentada con recuperación) es la técnica que resuelve exactamente eso: en lugar de reentrenar el modelo, le entregas los documentos relevantes dentro del prompt, en cada pregunta. Es la arquitectura detrás de la mayoría de los chatbots corporativos serios — incluido el agente de soporte que usamos en HexagonalGuru — y esta guía explica cómo funciona sin humo.
El Problema: El Modelo No Sabe (y No Sabe Que No Sabe)
Un LLM es una función de su entrenamiento: si un dato no estaba ahí, no existe para él. Y como no tiene una señal de «esto me lo estoy inventando», rellena los huecos con respuestas plausibles. Es lo que llamamos alucinaciones.
Las alternativas típicas tienen problemas serios:
- Fine-tuning con tus datos: caro, se desactualiza en cuanto cambia un documento, y el modelo sigue sin poder citar de dónde salió cada afirmación.
- Meterlo todo en el prompt: tu base de conocimiento no cabe en una ventana de contexto (y si cabe, pagas cada token en cada llamada).
- Confiar en la memoria del modelo: inaceptable cuando la respuesta compromete a tu empresa ante un cliente.
La Idea Central
RAG divide el problema en dos fases: primero encontrar los fragmentos de documento relevantes para la pregunta, y después generar la respuesta usando esos fragmentos como contexto. Retrieve, Augment, Generate:
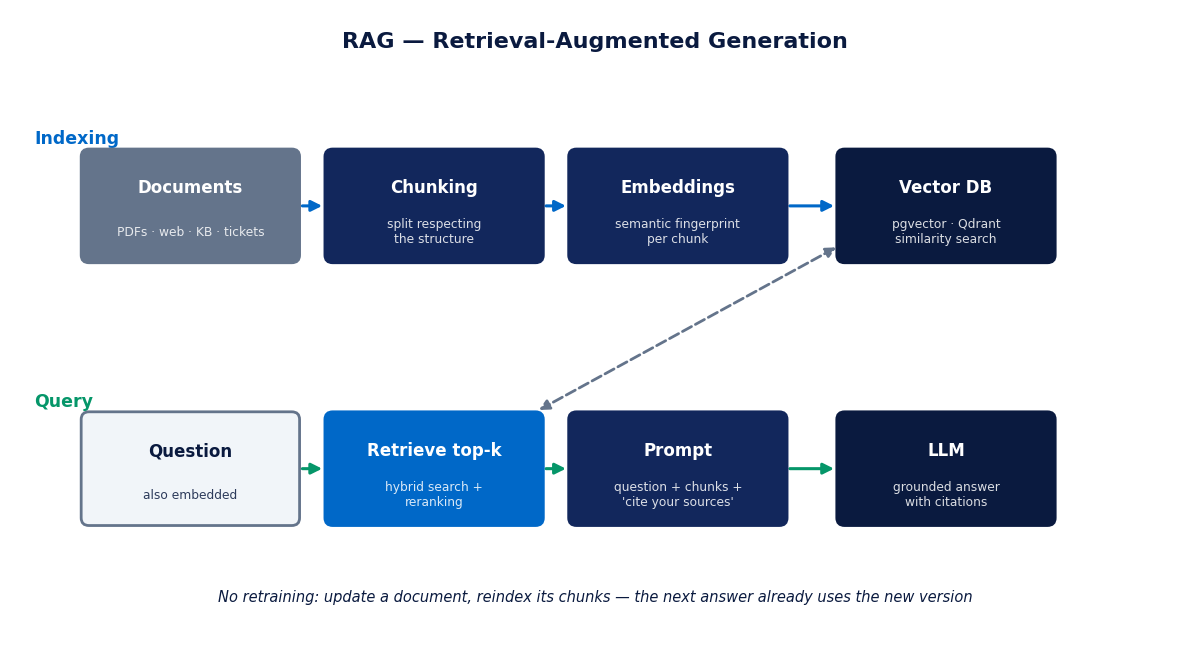
Fase 1: Indexación (una vez, y cada vez que cambia un documento)
- Ingesta: tus documentos (PDFs, web, base de conocimiento, tickets) se trocean en fragmentos (chunks) de tamaño razonable — ni un párrafo suelto sin contexto, ni un capítulo entero.
- Embeddings: cada chunk pasa por un modelo que lo convierte en un vector numérico: una «huella semántica» donde textos con significado parecido quedan cerca.
- Base vectorial: los vectores se guardan en una base de datos especializada (pgvector, Qdrant, Weaviate…) que permite buscar por similitud en milisegundos.
Fase 2: Consulta (en cada pregunta)
- La pregunta del usuario se convierte también en embedding.
- Se recuperan los k chunks más similares (top-k), idealmente con búsqueda híbrida y reranking — lo veremos en los errores comunes.
- Esos fragmentos se insertan en el prompt con una instrucción clara: «responde solo con esta información y cita la fuente».
- El LLM genera la respuesta anclada en tus documentos, con citas verificables.
El Retrieval Es Donde se Gana o se Pierde
El LLM es la parte vistosa, pero la calidad de un RAG se decide en la recuperación: si el fragmento correcto no llega al prompt, el modelo alucinará igual de elegante que antes. La arquitectura que funciona en producción tiene tres pisos:
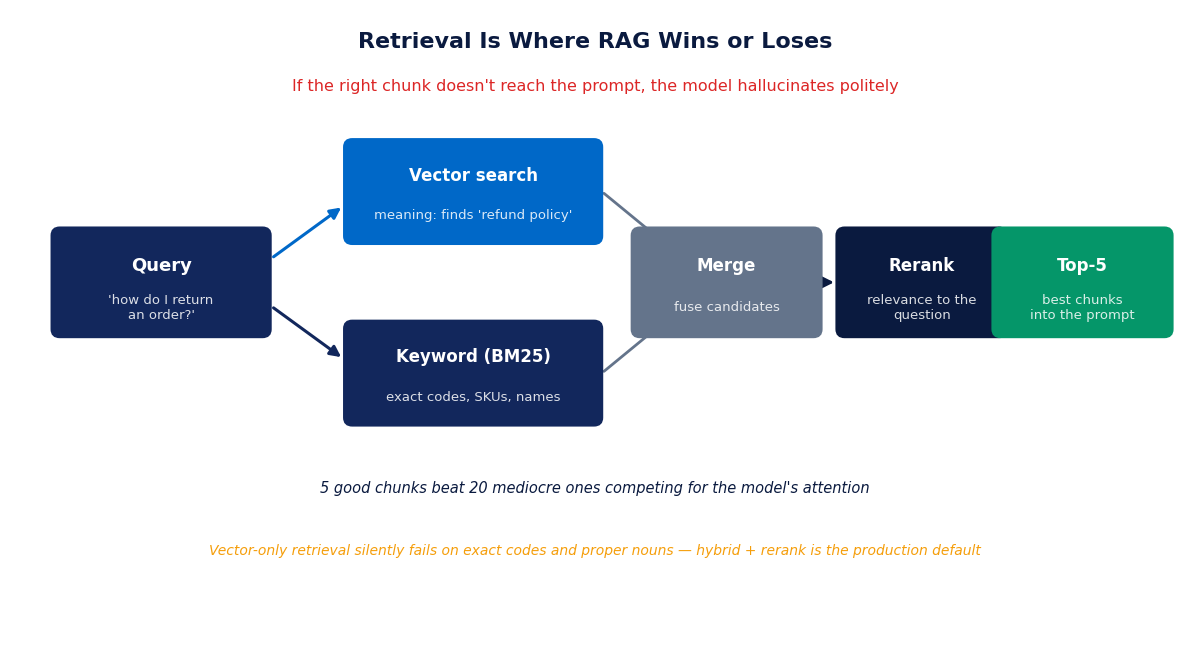
- Búsqueda híbrida: la búsqueda vectorial entiende el significado («¿cómo devuelvo un pedido?» encuentra «política de reembolsos»), pero falla con códigos exactos, SKUs y nombres propios; la búsqueda por palabra clave (BM25) hace justo lo contrario. Se ejecutan en paralelo y se fusionan los resultados.
- Reranking: un segundo modelo reordena los candidatos por relevancia real respecto a la pregunta. Es barato y mejora el retrieval de forma notable.
- Top-k con cabeza: mejor 5 fragmentos buenos que 20 mediocres compitiendo por la atención del modelo.
Un Ejemplo Mínimo
El núcleo de la consulta, simplificado, cabe en pantalla:
// 1. Embedding de la pregunta
$vector = $embeddings->embed($pregunta);

// 2. Recuperar los fragmentos mas similares (busqueda hibrida + rerank)
$chunks = $vectorStore->buscarSimilares($vector, limite: 5);

// 3. Construir el prompt con el contexto recuperado
$prompt = "Responde SOLO con esta informacion y cita la fuente.\n\n"
    . implode("\n\n", array_map(
        fn ($c) => "[Fuente: {$c->documento}]\n{$c->texto}",
        $chunks,
    ))
    . "\n\nPregunta: {$pregunta}";

// 4. Generar
$respuesta = $llm->completar($prompt);
Fíjate en lo que no hay: ningún entrenamiento, ningún modelo propio. Cuando actualizas un documento, se reindexa su chunk y la siguiente respuesta ya usa la versión nueva.
Qué Ganas
- Respuestas con tus datos, siempre actualizadas. Cambia el documento, cambia la respuesta. Sin reentrenar nada.
- Citas verificables. Cada afirmación puede enlazar a su fuente: la diferencia entre «un chatbot» y una herramienta en la que tu equipo confía.
- Control de acceso. El retrieval filtra por lo que cada usuario puede ver: un comercial no recupera documentos de dirección.
- Coste razonable. Pagas embeddings una vez por documento y unos pocos tokens de contexto por consulta. Nada de fine-tuning recurrente.
- Tus datos no entrenan a nadie. Los documentos viajan en el prompt de cada llamada, no al proceso de entrenamiento del proveedor.
Cuándo No es la Respuesta
- Quieres cambiar el comportamiento, no el conocimiento. Tono, formato de salida, estilo de respuesta: eso se consigue con prompts bien diseñados o, en casos extremos, con fine-tuning. RAG aporta datos, no personalidad.
- Tu problema es de búsqueda pura. Si el usuario quiere «el PDF de la factura de marzo», un buen buscador tradicional resuelve sin LLM. No todo problema de información es un problema de generación.
- Dominio ultraespecializado con jerga propia. Si el modelo base no entiende el vocabulario de tu sector ni con los documentos delante, toca evaluar modelos específicos o fine-tuning además de RAG.
- Datos 100% estructurados y consultas exactas. «¿Cuántos pedidos hubo ayer?» se responde con SQL, no con embeddings. (Aunque puedes combinar: tool calling para los datos, RAG para los documentos.)
Errores Comunes
- Chunks mal cortados. Fragmentos que parten ideas por la mitad o mezclan tres temas. El chunking respeta la estructura del documento (secciones, tablas) o destruye la calidad del retrieval.
- Confiar ciegamente en la búsqueda vectorial. Sin híbrido ni reranking, las consultas con códigos exactos y nombres propios fallan de forma silenciosa — y el modelo alucina para compensar.
- No evaluar. Sin un conjunto de preguntas reales con sus respuestas esperadas (un «golden set»), cada mejora es una corazonada. El retrieval se mide: ¿llegó el fragmento correcto al top-5?
- Meter todo lo recuperado en el prompt. Veinte chunks mediocres diluyen a cinco buenos y disparan el coste por consulta.
- Olvidar los permisos. Si el retrieval no filtra por los documentos que el usuario puede ver, tu chatbot acaba de saltarse el control de acceso de toda la empresa.
En Resumen
RAG es hoy la forma estándar de conectar un LLM con los datos de una empresa: indexa tus documentos en una base vectorial, recupera lo relevante en cada pregunta — con búsqueda híbrida y reranking — y deja que el modelo redacte anclado en ese contexto. El resultado: respuestas actualizadas, citables y dentro del perímetro de permisos, sin reentrenar nada. La parte difícil no es el LLM: es la ingeniería del retrieval.
Si estás valorando un asistente sobre tu documentación, tu catálogo o tu histórico de soporte, es exactamente lo que construimos: del pipeline de ingesta al despliegue en producción. Hablemos de tu caso →
Sigue leyendo: ¿Cuánto cuesta el software a medida? Una guía honesta de presupuestos.