La demo fue espectacular. El LLM resumió el documento, respondió las preguntas del cliente y hasta encontró un error que nadie había visto. Tres meses después, en producción, el mismo sistema inventa datos un 4% de las veces, cuesta más que el salario de la persona que hacía la tarea y nadie sabe explicar por qué ayer respondió eso. La distancia entre demo y producto es donde mueren la mayoría de las integraciones de IA.
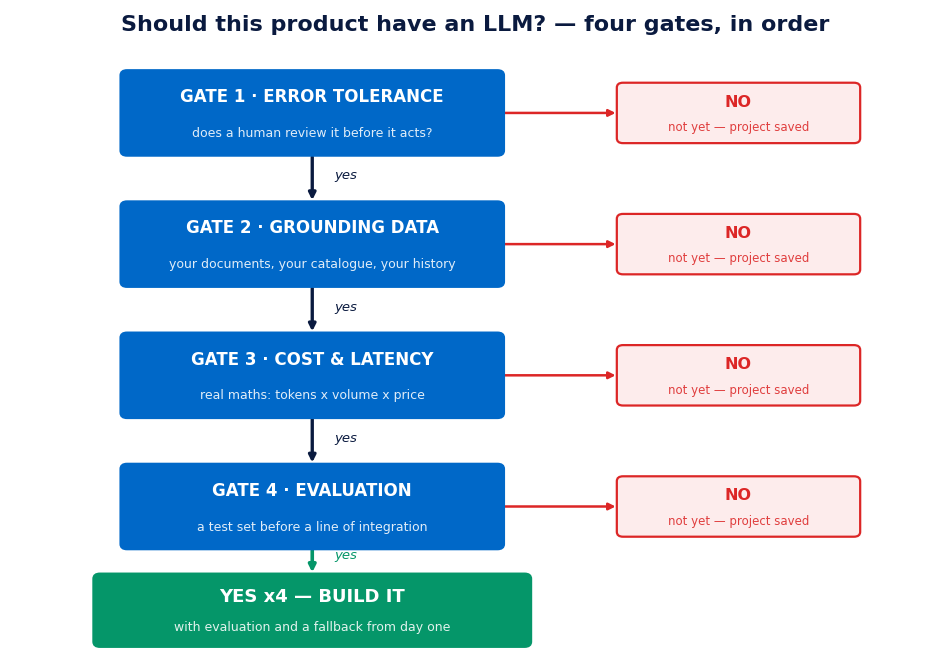
La pregunta correcta no es «¿podemos meter un LLM?» — técnicamente casi siempre se puede — sino «¿debe este producto llevar un LLM?». Esta guía es la checklist que usamos para responderla sin hype: cuatro puertas que hay que cruzar en orden, y si una se cierra, ahí termina el proyecto (y eso también es un buen resultado, porque te has ahorrado seis meses).
Lo que un LLM Hace Bien (y Lo que No)
Un LLM es un motor de lenguaje: transforma, resume, clasifica, extrae, redacta y conversa con una soltura que ninguna otra tecnología iguala. Lo que no es: una base de datos (no «sabe», predice), un sistema determinista (la misma entrada puede dar salidas distintas) ni un garante de verdad (cuando no sabe, también escribe con soltura).
Toda la checklist se deduce de esas tres limitaciones. Si tu caso de uso puede convivir con ellas, hay producto. Si las contradice, hay problema.
Las Cuatro Puertas de la Checklist
Puerta 1: ¿El error es tolerable?
El LLM fallará. No si, sino cuándo y cómo de grave. Si la respuesta errónea la revisa un humano antes de que tenga efecto (borradores, sugerencias, resúmenes internos), la puerta se abre. Si la respuesta actúa directamente sobre el mundo — un cálculo médico, una transferencia, un texto legal firmado — necesitas una capa de validación tan fuerte que a menudo el LLM deja de ser la parte útil del sistema. Regla rápida: LLM para proponer, reglas para disponer.
Puerta 2: ¿Tienes datos para anclarlo?
El modelo general sabe de todo y de nada en particular. El valor de producto aparece cuando lo anclas a tus datos: tus documentos, tu catálogo, tu histórico. Eso es exactamente lo que resuelve la generación aumentada con recuperación (RAG). Si no tienes datos de anclaje — o los tienes pero están desperdigados, desactualizados o sin permisos claros — el LLM responderá con la media de internet, y para eso tu usuario ya tiene ChatGPT.
Puerta 3: ¿El coste y la latencia encajan en la operación?
Cada llamada cuesta céntimos y segundos. En una demo es irrelevante; en un flujo que se ejecuta cien mil veces al día es la diferencia entre margen y ruina. Haz la cuenta con números reales: tokens por operación × volumen esperado × precio del modelo, y compara con el coste actual de la tarea. La latencia es la otra mitad: si el usuario espera la respuesta en pantalla, dos segundos de streaming pueden ser aceptables; si es un paso intermedio de una cadena síncrona, quizá no. Los modelos pequeños y el caching de respuestas mueven mucho esta frontera — pero hay que medirlos, no asumirlos.
Puerta 4: ¿Puedes evaluar que funciona?
Es la puerta que más proyectos ignoran y la que más importa. Si no puedes definir qué es una respuesta buena y medirla de forma repetible — un conjunto de casos de prueba con respuestas esperadas, una revisión humana muestreada, métricas de aceptación por el usuario — no tienes un producto: tienes una demo permanente. Sin evaluación, cada cambio de prompt o de modelo es un salto al vacío, y la degradación silenciosa (el proveedor actualiza el modelo y tu calidad cae un 10%) te enterarás por quejas.
Las Señales de que Sí Encaja
- Tarea de lenguaje con volumen. Resumir, clasificar, extraer o redactar cientos de veces al día, donde hoy lo hace una persona o simplemente no se hace.
- Humano en el bucle. El resultado lo revisa alguien antes de que tenga consecuencias, o el fallo es recuperable y barato.
- Datos propios disponibles y con permiso. Hay corpus que ancla las respuestas en tu realidad, no en la media de internet.
- Calidad medible. Puedes construir un set de evaluación de 50-200 casos representativos antes de escribir una línea de integración.
- La alternativa es peor. Hoy la tarea no se hace, se hace mal o cuesta más que el LLM incluyendo sus errores corregidos.
Las Señales de que No
- «Porque la competencia lo tiene». La IA como checkbox de marketing produce features que nadie usa y que cuestan todos los meses. Si no hay tarea concreta, no hay producto.
- Precisión obligatoria. Contabilidad, dosis, cumplimiento legal: si la respuesta debe ser correcta siempre, el LLM solo puede ser asistente borrador, nunca la fuente.
- El problema era de datos. Si la información está mal, dispersa o desactualizada, el LLM la servirá mal, dispersa y desactualizada — con mejor redacción. Primero se arreglan los datos.
- Una regla de negocio disfrazada. «Clasificar tickets en tres categorías fijas» se resuelve con una keyword y un switch desde 1995. Si el dominio es cerrado y las reglas son conocidas, el código clásico gana en coste, latencia y fiabilidad.
- Nadie medirá el resultado. Si no hay presupuesto ni voluntad para evaluar calidad de forma continua, lo que se despliega no es una feature: es una fe.
Los Costes que No Salen en la Demo
El precio de la API es la parte visible. Debajo: el pipeline de datos para el anclaje, la evaluación continua, la monitorización de deriva (el modelo cambia sin avisar), la gestión de prompts como artefactos versionados, el cumplimiento normativo — con el Reglamento Europeo de IA ya en vigor, conviene saber en qué categoría de riesgo cae tu caso de uso — y la formación del equipo que lo operará. Un presupuesto honesto multiplica la línea de la API por tres o cuatro. Si el negocio sigue cerrando con esa cifra, adelante; si solo cerraba con el precio de la API, mejor saberlo ahora.
Errores Comunes
- Empezar por la tecnología. «Tenemos que usar GPT-X» antes de tener la tarea. El modelo se elige al final, cuando se sabe qué precisión, latencia y coste necesita el caso — y muchas veces el ganador es uno pequeño y barato.
- Medir con la demo feliz. Cinco ejemplos escogidos a mano no son una evaluación. Sin set de pruebas representativo, la decisión de lanzar es una moneda al aire.
- Esconder la incertidumbre al usuario. Presentar la salida del LLM con la misma autoridad visual que un dato calculado invita a confiar donde no se debe. La interfaz debe distinguir lo afirmado de lo sugerido.
- Agentes antes que cimientos. Poner un agente autónomo sobre un caso que no pasa la checklist solo multiplica el error por la cantidad de pasos que ejecuta. Los agentes amplifican lo que hay: si hay calidad, calidad; si hay humo, humo a escala.
- Olvidar la salida de emergencia. Qué pasa cuando el proveedor cae, el modelo se degrada o el coste se dispara. Un fallback — aunque sea «esta función está temporalmente limitada» — es parte del diseño, no un extra.
En Resumen
Un LLM encaja en tu producto cuando cruza cuatro puertas en orden: el error es tolerable, tienes datos propios para anclarlo, el coste y la latencia cierran en la cuenta real, y puedes evaluar la calidad de forma continua. Si una puerta se cierra, la respuesta honesta es «todavía no» — y esa respuesta vale más que cualquier prototipo. La IA que funciona en producción no es la más impresionante: es la que alguien midió.
Si estás valorando integrar IA en tu producto y quieres una respuesta con números y no con entusiasmo, podemos recorrer esta checklist con tu caso concreto. Hablemos →
Sigue leyendo: Qué es RAG: guía práctica para dar tus datos a un LLM.