El problema: el LLM más potente no sabe nada de tu empresa
Los modelos de lenguaje actuales redactan, resumen y razonan con una soltura impresionante. Pero tienen dos limitaciones que cualquier empresa descubre en la primera semana de uso real: no conocen tu negocio (tus productos, tus tarifas, tus procedimientos, tu documentación interna) y, cuando no saben algo, tienden a inventárselo con la misma seguridad con la que aciertan.
Para un asistente que responde a clientes o a empleados, eso es inaceptable. La solución que se ha impuesto en la industria para resolverlo se llama RAG.
Qué es RAG, explicado sin jerga
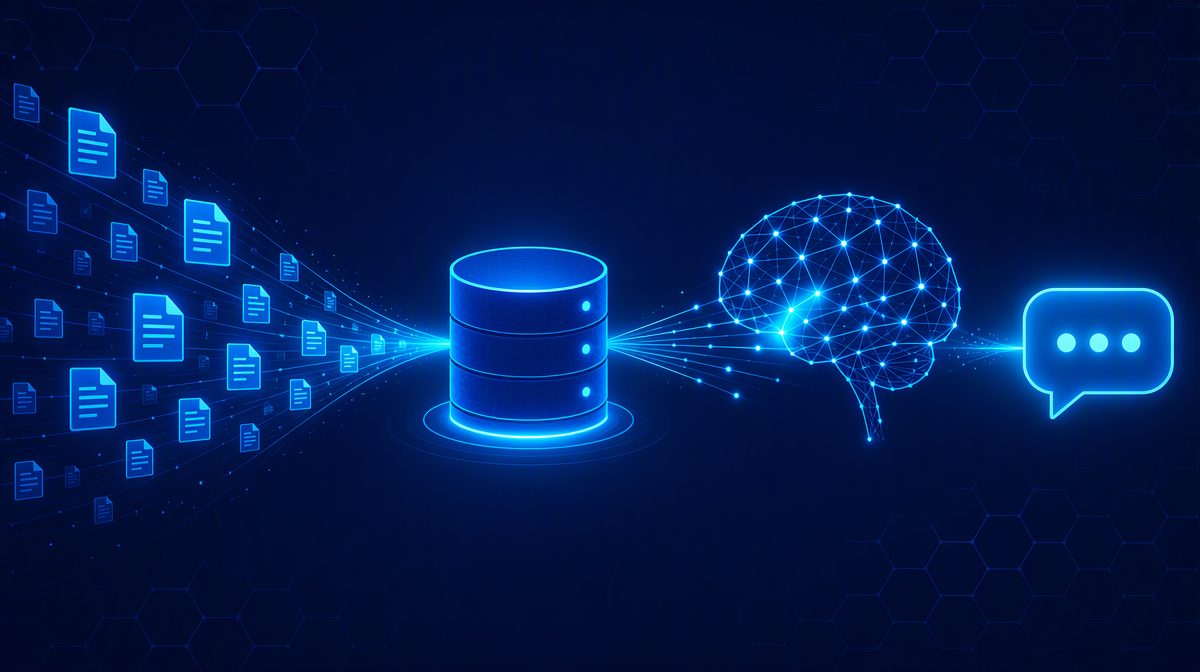
RAG (Retrieval-Augmented Generation, generación aumentada con recuperación) es una arquitectura que combina dos pasos antes de responder:
- Recuperar: cuando llega una pregunta, el sistema busca primero en tu documentación los fragmentos más relevantes —manuales, FAQs, contratos, tickets, artículos de base de conocimiento—.
- Generar: esos fragmentos se entregan al modelo como contexto, con instrucciones de responder basándose en ellos (y, bien hecho, citándolos).
El cambio cualitativo es enorme: el modelo deja de responder «de memoria» y pasa a responder con tus documentos delante. Menos invención, respuestas trazables y conocimiento siempre actualizado — si actualizas un documento, la siguiente respuesta ya lo refleja, sin reentrenar nada.
Cómo funciona por dentro
Un sistema RAG tiene cuatro piezas principales:
- Ingesta y troceado (chunking): tus documentos se dividen en fragmentos con sentido propio. Este paso parece trivial y es de los que más determinan la calidad final.
- Embeddings: cada fragmento se convierte en un vector numérico que captura su significado. Preguntas y documentos se comparan por significado, no por palabra exacta — el sistema encuentra «política de devoluciones» aunque preguntes «¿puedo devolver un pedido?».
- Base de datos vectorial: el índice donde viven esos vectores y que permite recuperar los fragmentos más afines a cada pregunta en milisegundos.
- Orquestación: la lógica que decide qué se recupera, cómo se construye el prompt, cuándo abstenerse («no tengo información suficiente») y cómo se cita la fuente.
Casos de uso que sí funcionan hoy
- Soporte al cliente: respuestas instantáneas basadas en tu base de conocimiento, con escalado a humano cuando toca. Es el caso con mejor retorno y el más maduro.
- Asistente de documentación interna: todo el conocimiento disperso en wikis, PDFs y carpetas compartidas, accesible preguntando en lenguaje natural.
- Apoyo comercial: respuestas sobre catálogo, tarifas y condiciones al instante, siempre con la versión vigente.
- Análisis de contratos y licitaciones: localizar cláusulas, comparar versiones y extraer obligaciones en segundos.
Lo que separa un RAG brillante de uno frustrante
Montar una demo de RAG toma una tarde. Que funcione bien en producción es otra historia. Estos son los factores que marcan la diferencia:
- Calidad del contenido fuente: si tu documentación está desactualizada o se contradice, el sistema la responderá tal cual. RAG premia la documentación sana.
- Chunking y metadatos: cómo se trocea y etiqueta cada documento determina qué se recupera. Es ingeniería, no magia.
- Saber decir «no lo sé»: un buen sistema detecta cuando la pregunta no tiene respuesta en las fuentes y lo admite, en vez de inventar.
- Evaluación continua: conjuntos de preguntas reales con respuestas esperadas, medición de aciertos y mejora iterativa. Sin esto, cada ajuste es una lotería.
- Latencia y coste por respuesta: en producción importan tanto como la precisión.
¿RAG o fine-tuning?
Dudas razonable y frecuente. Regla práctica:
- RAG es la respuesta cuando lo que necesitas es que el modelo sepa cosas: datos, documentos, conocimiento cambiante. No reentrena nada, se actualiza solo y cada respuesta puede citar su fuente.
- Fine-tuning sirve para que el modelo se comporte de cierta manera: tono, formato, estilo de respuesta muy específico. No es buen mecanismo para «meterle conocimiento», y requiere reentrenar cuando los datos cambian.
En la mayoría de proyectos empresariales la respuesta es RAG primero, y fine-tuning solo si hay una necesidad de comportamiento que los prompts no resuelven.
Privacidad y cumplimiento: la pregunta que hay que hacer
Antes de conectar documentación interna a cualquier modelo conviene responder tres preguntas: ¿dónde se procesan los datos?, ¿se usan para entrenar modelos de terceros?, ¿quién puede ver qué? Con la regulación europea de IA en marcha y el RGPD plenamente vigente, estas respuestas no son opcionales. La buena noticia: hoy es viable montar RAG con modelos y bases vectoriales desplegados en infraestructura europea —o incluso propia— sin enviar un solo dato fuera.
Cómo lo planteamos nosotros
Nuestro enfoque con la IA es el mismo que con el resto de la ingeniería: empezar por el caso de uso con retorno claro, construir sobre arquitectura mantenible y medir antes de escalar. Un piloto de RAG bien acotado —una fuente documental, un canal, evaluación desde el primer día— suele ser cuestión de semanas, y deja la base lista para crecer.
Si te preguntas cuánto de lo que tu equipo busca a diario en carpetas y wikis podría responderse al instante, probablemente tienes un caso. Cuéntanos qué documentación tienes y qué preguntas se repiten, y te diremos con franqueza si RAG lo resuelve — y qué haría falta para ponerlo en producción.