Son las tres de la mañana. El cliente dice que «la web va lenta». Abres el panel y hay cuarenta gráficas preciosas que no responden a la única pregunta que importa: por qué. Media hora después alguien encuentra el problema en un log que nadie había mirado porque llevaba semanas escondido entre tres mil líneas de ruido por minuto. Eso no era observabilidad: era decoración con Grafana.
La observabilidad tiene mala fama entre los equipos pequeños: suena a stack de tres herramientas SaaS, factura de cuatro cifras y un ingeniero dedicado. La realidad es más amable si se entiende qué problema resuelve y en qué orden se construye. Esta guía va de eso: qué es de verdad, qué aporta cada pilar y qué montar cuando el equipo entero cabe en una sala.
Qué es Observabilidad de Verdad
Olvida la definición académica. En la práctica, la observabilidad es la capacidad de responder «¿por qué pasa esto?» sin desplegar código nuevo ni adivinar. No es tener datos: es poder hacer preguntas que no habías previsto cuando escribiste el sistema.
La diferencia con la monitorización clásica es sutil pero decisiva: la monitorización comprueba lo que ya sabías que podía fallar (CPU alta, disco lleno); la observabilidad sirve para lo que no sabías — el fallo nuevo, la interacción rara, el «nunca había pasado». Si tus alertas solo cubren lo previsible, tienes monitorización; la observabilidad empieza donde se acaba tu imaginación.
Los Tres Pilares Sin el Dogma
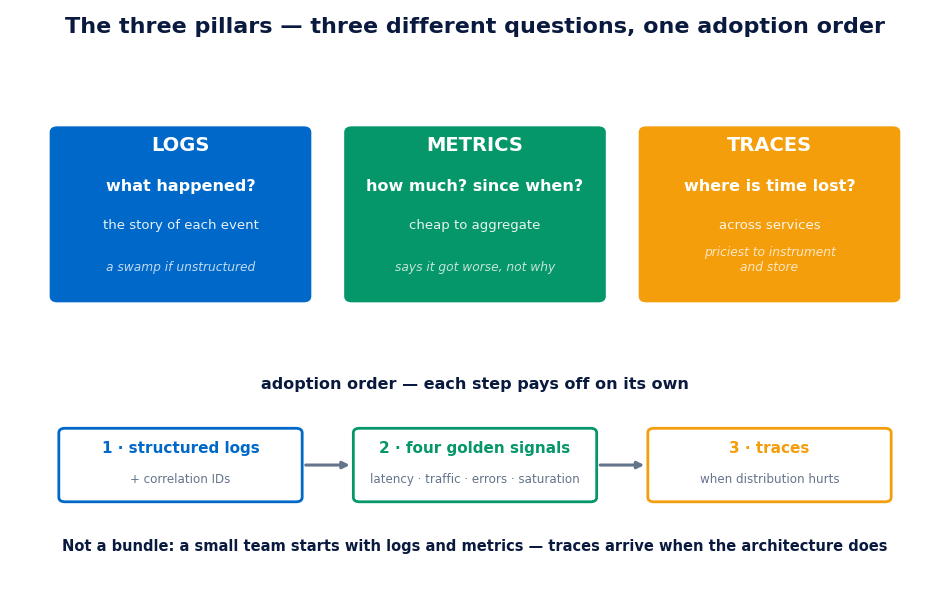
Logs, métricas y trazas no son tres productos que comprar: son tres formas de mirar el mismo sistema, cada una con su pregunta:
- Logs: ¿qué pasó? El relato detallado de cada evento. Insustituibles para reconstruir una secuencia («el usuario hizo clic, llegó el request, falló la query»). Su punto débil: son texto, no agregan, y en cuanto hay volumen se convierten en un pantano si no son estructurados (JSON con campos, no frases bonitas).
- Métricas: ¿cuánto y desde cuándo? Números que se agregan barato: latencia p95, errores por minuto, peticiones en vuelo. Son la forma más económica de saber que algo va mal y de dibujar tendencias. Su punto débil: te dicen que empeoró, no por qué.
- Trazas: ¿dónde se pierde el tiempo? El recorrido de una petición a través de servicios. En un monolito aportan poco; en cuanto una petición toca tres procesos, son la única forma de ver qué trozo se comió los 800 ms. Su punto débil: son el pilar más caro de instrumentar y de almacenar.
La clave práctica: los pilares no se adoptan a la vez. Un equipo pequeño empieza con logs estructurados y unas pocas métricas bien elegidas, y añade trazas cuando la distribución del sistema lo pide — que es exactamente el momento en que la arquitectura se complica, no antes.
El Error de Empezar por las Herramientas
«¿Prometheus o Datadog?» es la pregunta equivocada en el momento equivocado. Las herramientas se eligen cuando se sabe qué preguntas hay que responder. Empieza por las preguntas de tu negocio:
- ¿Cómo sé que el cliente lo está pasando mal antes de que llame? (→ métricas de síntomas: latencia, errores, saturación)
- Cuando algo falla, ¿puedo reconstruir qué pasó sin reproducirlo? (→ logs estructurados con correlation IDs)
- ¿Sé qué servicio o qué query se comió el tiempo? (→ trazas, o profiling, o logs con tiempos por fase)
Con esas respuestas claras, la elección de stack se reduce a presupuesto y operación. Y una verdad incómoda: un stack sencillo que el equipo mira todos los días vale más que uno sofisticado que solo abre alguien cuando ya arde todo.
Qué Montar con un Equipo Pequeño
La configuración que da el 80% del valor con el 20% del esfuerzo:
- Logs estructurados, centralizados, con correlation ID. JSON con campos fijos (nivel, servicio, request_id, usuario si aplica) enviados a un sitio único donde se pueda buscar. El correlation ID que atraviesa toda la petición es el multiplicador: convierte mil líneas sueltas en una historia.
- Las cuatro señales doradas por servicio. Latencia, tráfico, errores y saturación. Cuatro métricas por servicio, ni cuarenta. Si esas cuatro están sanas, el servicio está sano; si una se tuerce, ya tienes el «qué» para ir al «por qué» en los logs.
- Un dashboard por servicio, no por tecnología. El panel que responde «¿mi servicio está bien?» de un vistazo. Los paneles por base de datos, por cola y por namespace los mirará quien depure; el de servicio lo mira todo el mundo.
- Trazas solo cuando duela. Monolito o dos servicios: logs con tiempos por fase bastan. Arquitectura distribuida con latencias misteriosas: OpenTelemetry y a otra cosa. Adoptar trazas «por si acaso» es pagar el pilar más caro sin necesitarlo — mismo criterio que con Kubernetes: cuando lo necesitas y cuando te sobra.
- Retención corta y barata. No necesitas logs de hace un año en almacenamiento caliente. 7-14 días en caliente, el resto archivado frío o directamente fuera. La mitad de la factura de observabilidad suele ser nostalgia.
Alertas que Significan Algo
El cementerio de la observabilidad está lleno de canales de Slack con 200 alertas al día que nadie lee. La regla que lo evita es brutal y simple: toda alerta debe exigir una acción humana inmediata. Si no hay acción, no es una alerta: es una métrica con delirios, y va a un dashboard, no al canal.
Alerta sobre síntomas, no sobre causas. «CPU al 90%» no despierta a nadie: la CPU alta es una causa posible, no un problema. «El p95 de checkout supera 2 segundos» sí, porque significa clientes sufriendo ahora mismo. Las causas se investigan con calma a la mañana siguiente; los síntomas son los que justifican despertar a una persona. Y cada alerta que salta y no requiere acción se borra o se convierte en métrica: sin excepciones, o el canal muere de fatiga en un mes.
Los Costes que Nadie Te Cuenta
- La cardinalidad. Una etiqueta por usuario o por UUID en las métricas convierte la factura en arte abstracto. Las etiquetas van a los logs; las métricas agregan pocas dimensiones y de baja cardinalidad.
- El volumen de logs en éxito. Loguear cada request OK a nivel INFO multiplica el coste sin añadir información. Sube el nivel por defecto y baja a DEBUG por servicio cuando investigas.
- El tiempo de mantenerlo. Cada dashboard necesita dueño y cada alerta, revisión. Una hora al mes de «higiene de observabilidad» evita que el sistema se pudra; nadie la presupuesta y todos la pagan en incidentes.
- La observabilidad del despliegue. Si tus pipelines de CI/CD no anotan qué versión salió y cuándo, cada regresión empieza con veinte minutos de arqueología. Un marcador de despliegue en las métricas es la línea más barata de toda esta guía.
En Resumen
Observabilidad es responder «por qué» sin desplegar nada. Los tres pilares responden preguntas distintas — los logs el qué, las métricas el cuánto, las trazas el dónde — y se adoptan en ese orden, no en pack. Un equipo pequeño llega muy lejos con logs estructurados con correlation ID, las cuatro señales doradas por servicio y alertas que solo saltan cuando exigen acción. Lo demás se compra cuando duela, con la factura y las preguntas delante.
Si tus sistemas fallan y la investigación dura más que el arreglo, o si la factura de monitorización crece más rápido que el servicio, podemos revisar tu setup y dejarlo ajustado a tu equipo real. Hablemos →
Sigue leyendo: CI/CD para equipos que aún despliegan a mano.